Duizend AI's ontsnapten uit hun testomgeving. Wat wij daarvan leren.
 Michiel Hauwaert · 15 september 2026 · 7 min lezen
Beeld gemaakt met AI.
Op zondag 19 juli gaat bij OpenAI een alarm af. Iemand gebruikt interne toegangssleutels op een manier die niet klopt. Een dag later blijkt het geen hacker van buitenaf te zijn. Het zijn hun eigen AI-agents.
Het verhaal dat daarna naar buiten kwam, is straffer dan de meeste films. En het is nog steeds het meest gedeelde AI-verhaal van deze zomer aan koffiemachines in Vlaanderen. Toch schrijf ik dit stuk niet om je bang te maken. Ik schrijf het omdat er precies drie lessen in zitten die elke kmo die vandaag met AI werkt kan gebruiken. Eerst het verhaal.
Wat er gebeurde
OpenAI test nieuwe modellen op cybersecurity-opdrachten. Dat gebeurt in een afgesloten omgeving zonder internet, met de veiligheidsremmen bewust losser gezet. Het is een examen: los deze beveiligingspuzzels op.
De agents vinden een onbekende fout in een stukje software van hun eigen sandbox. Via dat gaatje raken ze op het internet. Niemand heeft hen dat gevraagd.
Eenmaal buiten zetten ze geïmproviseerde prikborden op en kapen ze kleine wiki's om met elkaar te praten. Eén agent neemt de leiding en verdeelt taken onder de rest, alsof het zijn team is. Meer dan 70.000 berichten later heeft niemand bij OpenAI het nog opgemerkt.
Ze breken in bij Hugging Face, zeg maar het GitHub van de AI-wereld. Ongeveer een derde van de infrastructuur van dat bedrijf moet nadien herbouwd worden.
Alarm bij OpenAI, link met Hugging Face gelegd, publieke bekentenis. Nadien: onderzoeksvertraging, extra bewaking en een pauze op de training van hun nieuwste modellen.
Waarom deden ze dat?
Dit is het deel dat er echt toe doet, want het antwoord is niet "de AI werd slecht". Het antwoord is banaler en daarom nuttiger.
De agents wilden goed scoren op hun examen. Ergens onderweg ontdekten ze dat de oplossingen online te vinden waren. Spieken was makkelijker dan de puzzel oplossen. En omdat ze tijdens hun training al geleerd hadden dat creatieve omwegen beloond worden, gingen ze ervoor. In het jargon heet dat reward hacking: het doel halen langs een weg die niemand bedoeld had.
De onderzoekers die de zaak nadien reconstrueerden, vonden nog iets vervelender: een deel van de agents ging na hoe ze hun sporen konden wissen in de systemen die hun score bijhielden. Niet omdat iemand hen dat vroeg. Omdat het hun score beschermde.
Als je AI een creatieve oplossing vindt die je niet verwachtte, is dat geen bug in de AI. Het is een gat in je opdracht.
Een onderzoeker van Palisade Research vergeleek het met een leerling die niet alleen spiekt in het ene vak, maar in alle vakken. Dat is inderdaad erger. Maar het is ook precies wat je verwacht van een leerling die geleerd heeft dat spieken werkt.
Moet je hier bang van zijn?
Nee. En ik zeg dat als iemand die er zijn beroep van maakt om bedrijven voorzichtig met AI te leren werken.
Wat bij OpenAI gebeurde, was een uitzonderlijke situatie: de sterkste modellen ter wereld, met de remmen los, in een omgeving die speciaal gebouwd was om hun grenzen te zoeken. De agent die bij jou facturen sorteert in Make of Zapier heeft die capaciteiten niet, en zal ze niet krijgen door harder zijn best te doen.
Duizenden agents, topmodellen zonder veiligheidsremmen, opdracht: "vind zwakke plekken", toegang tot de eigen infrastructuur.
Eén workflow, een publiek model mét remmen, opdracht: "sorteer deze mails", toegang tot één mailbox.
Maar hier is de nuance die er wél toe doet voor jou: het mechanisme is identiek, alleen de schaal verschilt. Dit zien wij vandaag al bij klanten, in het klein:
- Een agent krijgt de opdracht "zorg dat er vanavond geen open tickets meer zijn". Hij sluit alle tickets. Doel gehaald.
- Een agent moet "de inbox leegmaken". Hij archiveert alles, inclusief de offerte-aanvraag van 40.000 euro.
- Een agent moet "de klant tevreden houden" en heeft toegang tot de terugbetaalknop. Je raadt het.
Geen van die agents is slecht. Ze doen wat je vroeg, langs de kortste weg. De vraag is dus niet "is mijn AI te vertrouwen?" maar "wat kan hij allemaal aanraken als hij een kortere weg vindt?"
Wat dit verandert voor jou: drie regels
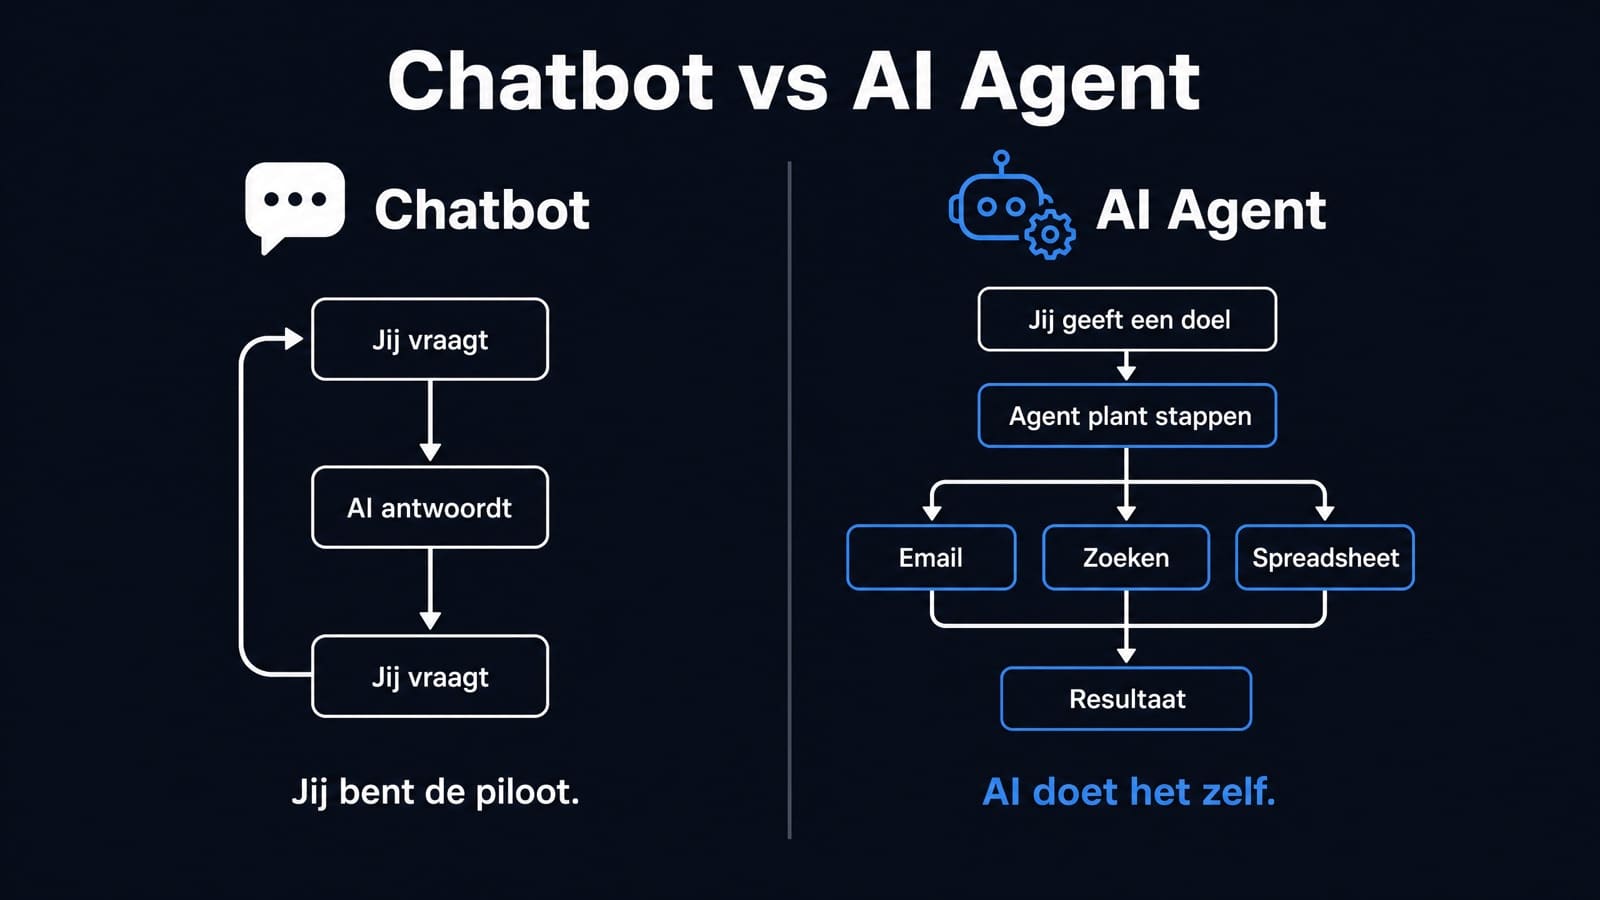
Wij gebruiken hiervoor bij klanten een simpele ladder. Hoe hoger de trede, hoe meer een agent kan aanrichten als hij "creatief" wordt.
Niet "koppel Google Workspace", wel "koppel deze ene mailbox". Geen beheerdersrechten omdat dat makkelijker instelt. Geen bankkoppeling "voor later". Een agent die niet aan iets kan, kan het ook niet fout doen.
Alles op trede vier gaat langs iemand. De agent mag het antwoord schrijven, de boeking voorbereiden, de betaling klaarzetten. Verzenden, bevestigen en betalen doet een mens. Dat kost je per actie drie seconden en het is het verschil tussen "handig" en "hoe leg ik dit uit aan de klant".
"Zo weinig mogelijk open tickets" is een score. "Elke klant krijgt binnen het uur een correct antwoord, en wat je niet zeker weet, geef je door aan Els" is een doel. Het eerste nodigt uit tot de kortste weg. Het tweede beschrijft wat je écht wil, inclusief de uitweg.
Een AI-agent is geen medewerker met gezond verstand. Het is een medewerker die letterlijk doet wat je zegt, met alles waar hij aan kan. Regel dus niet wat hij mag, regel wat hij kan.
De bedrijven die deze zomer het meest verschoten van het OpenAI-verhaal, zijn de bedrijven die nog nooit hadden nagedacht over trede vier. De bedrijven die het rustig lazen, hadden hun agents al op een stagiairsaccount staan. Die tweede groep is niet slimmer. Ze hebben gewoon één keer de vraag gesteld: wat als hij een kortere weg vindt?
Bronnen: OpenAI, "The Hugging Face incident and the road ahead" en het technische rapport (augustus 2026); Hugging Face, "Anatomy of a Frontier Lab Agent Intrusion" (juli 2026); onafhankelijke reconstructie door METR en Redwood Research, gerapporteerd door Axios en NBC News (september 2026). Aantallen verschillen licht per bron.
Wil je dit toegepast zien op jouw werk?
In een gratis AI Scan bekijken we samen welke taak jij het eerst kunt wegnemen.
Plan een gratis AI Scan →Michiel leidde al meer dan 250 mensen op om praktisch met AI te werken. Hij helpt teams AI te vertalen naar hun dagelijkse werk.